Мы используем cookies для корректной работы сайта и подключаем аналитику (Яндекс.Метрика), чтобы понимать, что улучшать
Как подобрать сервер для нейросети: расчет GPU и видеопамяти
Перед покупкой сервера под локальную языковую модель нужно ответить на три вопроса: сколько видеопамяти потребует модель, сколько для этого нужно ускорителей и что еще должно быть в сервере, кроме GPU. Ошибка в любую сторону стоит дорого: либо модель не помещается в память и тормозит, как только к ней обращаются десять сотрудников, либо половина купленных карт простаивает. Разберем, как посчитать ресурсы и перевести расчет в конфигурацию сервера – с формулами, примерами и типичными ошибками.
Сколько GPU и видеопамяти нужно нейросети
- Под веса модели нужно примерно 2 ГБ на каждый миллиард параметров в FP16, 1 ГБ – в FP8 или INT8 и около 0,6 ГБ – в INT4.
- Сверху добавляется KV-кэш: у моделей класса Llama 3.1 это от 1 до 2,5 ГБ на каждый одновременный запрос с контекстом 8K токенов. И еще 10–20% служебного запаса.
- Для 20 одновременных запросов модели 8B хватает одной карты на 48 ГБ, модели 70B в FP8 нужны две карты по 80 ГБ. С запасом на рост сервер берут со свободными слотами под дополнительные ускорители: например, в YADRO G4208P G3 можно начать с двух карт и по мере роста нагрузки дойти до восьми.
- Полное дообучение требует около 16 байт на параметр, поэтому для большинства задач выбирают LoRA, QLoRA или RAG без дообучения.
От чего зависят требования к железу
Потребность в видеопамяти определяют четыре вещи:
• Размер модели. Число параметров – те самые 7B, 32B или 70B в названии, где B означает миллиарды.
• Точность весов. Одна и та же модель в FP16 занимает примерно в 3,5–4 раза больше памяти, чем после квантизации до 4 бит.
• Длина контекста. Чем длиннее запрос с документами и историей диалога, тем больше памяти занимает служебный KV-кэш.
• Число одновременных запросов. KV-кэш нужен каждому запросу отдельно, поэтому 20 пользователей требуют в 20 раз больше памяти под контекст, чем один.
Еще один фактор – задача: работа готовой модели (инференс) и ее дообучение отличаются по требованиям в разы.
Как посчитать видеопамять для работы модели
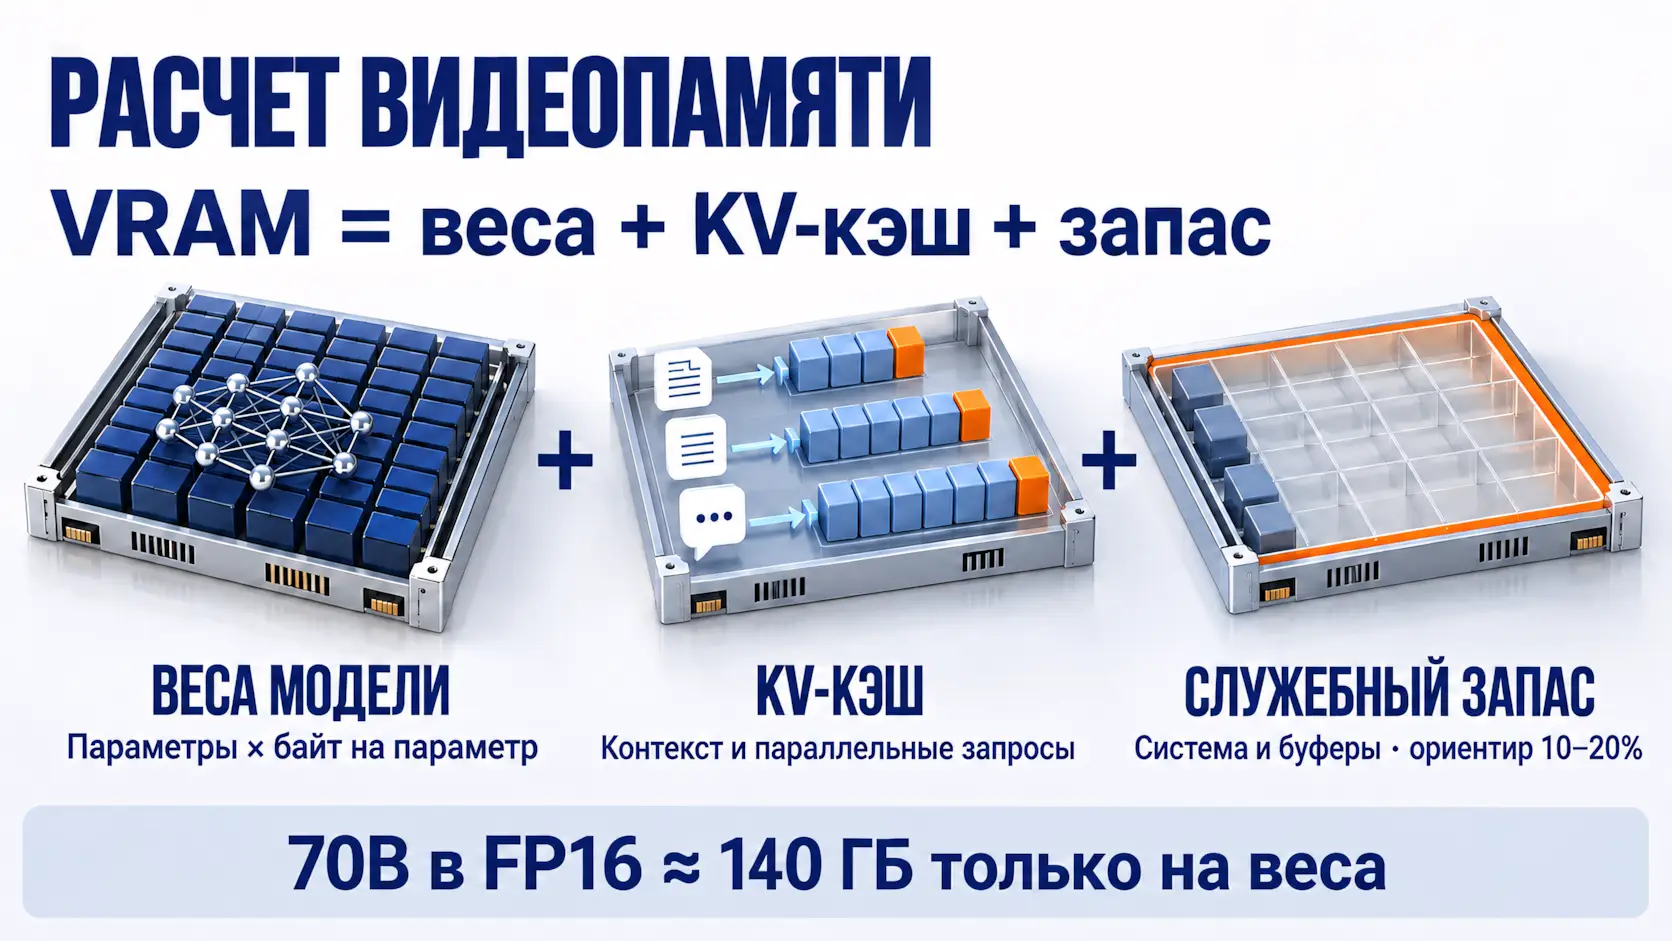
Память под инференс складывается из трех частей:
Память = веса модели + KV-кэш + служебный запас
Веса модели
Размер весов – это число параметров, умноженное на размер одного параметра в байтах. В форматах FP16 и BF16 параметр занимает 2 байта, в FP8 и INT8 – 1 байт, в INT4 – полбайта. Модель на 70 миллиардов параметров в FP16 занимает около 140 ГБ – только веса, без контекста.
| Модель | FP16 / BF16 | FP8 / INT8 | INT4 |
|---|---|---|---|
| 8B | 16 ГБ | 8 ГБ | около 5 ГБ |
| 14B | 28 ГБ | 14 ГБ | около 8 ГБ |
| 32B | 64 ГБ | 32 ГБ | около 18 ГБ |
| 70B | 140 ГБ | 70 ГБ | около 40 ГБ |
У 4-битных моделей реальный размер на 10–15% больше расчетного: к весам добавляются коэффициенты масштаба, а часть слоев остается в повышенной точности. Квантизация экономит память, но немного снижает качество ответов. Для рабочих задач часто выбирают FP8 или INT8, а 4 бита оставляют для случаев, когда модель иначе не помещается в железо.
Модели со смесью экспертов (MoE). В таких моделях на каждый токен работает только часть параметров, но в памяти должны лежать все. У DeepSeek-V3 671 миллиард параметров, из них на каждый токен активируется 37 миллиардов. Памяти ей нужно как модели на 671B – около 670 ГБ под веса в FP8, больше, чем есть у восьми карт по 80 ГБ. А скорость генерации для одного пользователя ближе к модели на 37B: на каждом шаге читается только активная часть весов.
KV-кэш: память под контекст
Чтобы не пересчитывать весь текст на каждом шаге, модель хранит промежуточные значения для каждого токена в памяти видеокарты. Это и есть KV-кэш. Его размер на один токен считается так:
Байт на токен = 2 × число слоев × число KV-голов × размер головы × байт на элемент
Двойка в начале – это две матрицы, K и V. Параметры архитектуры есть в файле конфигурации любой открытой модели. Затем размер на токен умножаем на длину контекста и на число одновременных запросов.
Пример для двух распространенных архитектур с KV-кэшем в FP16:
| Архитектура | Слои / KV-головы / размер головы | На токен | Один запрос, 8K токенов | Один запрос, 128K токенов |
|---|---|---|---|---|
| Llama 3.1, 8B | 32 / 8 / 128 | 128 КБ | около 1 ГБ | около 16 ГБ |
| Llama 3.1, 70B | 80 / 8 / 128 | 320 КБ | около 2,5 ГБ | около 40 ГБ |
Отсюда главный вывод: на длинном контексте и с несколькими пользователями KV-кэш легко сравнивается с весами модели, а то и превышает их. Современные серверы инференса умеют хранить кэш в FP8 – это вдвое меньше памяти при небольшой потере точности.
Сильнее всего на размер кэша влияет число KV-голов. Современные модели используют групповое внимание (GQA): несколько голов запроса делят одну пару K и V. У Llama 2 7B такого механизма нет, и ее кэш занимает 512 КБ на токен – в четыре раза больше, чем у Llama 3.1 8B, хотя модели почти одного размера. Поэтому перед расчетом проверьте параметр num_key_value_heads в файле config.json модели.
Служебный запас
Часть видеопамяти всегда уходит не на модель, а на систему, буферы вычислений, активации и фрагментацию – в сумме 10–20% объема. Серверы инференса заранее оставляют резерв: например, vLLM по умолчанию отводит под веса, активации и KV-кэш 90% памяти каждой видеокарты, а 10% оставляет системе. Считать впритык нельзя: модель, которой нужно 95% памяти, либо не запустится, либо сможет обслуживать одного-двух пользователей.
Инференс и дообучение: почему разница в разы
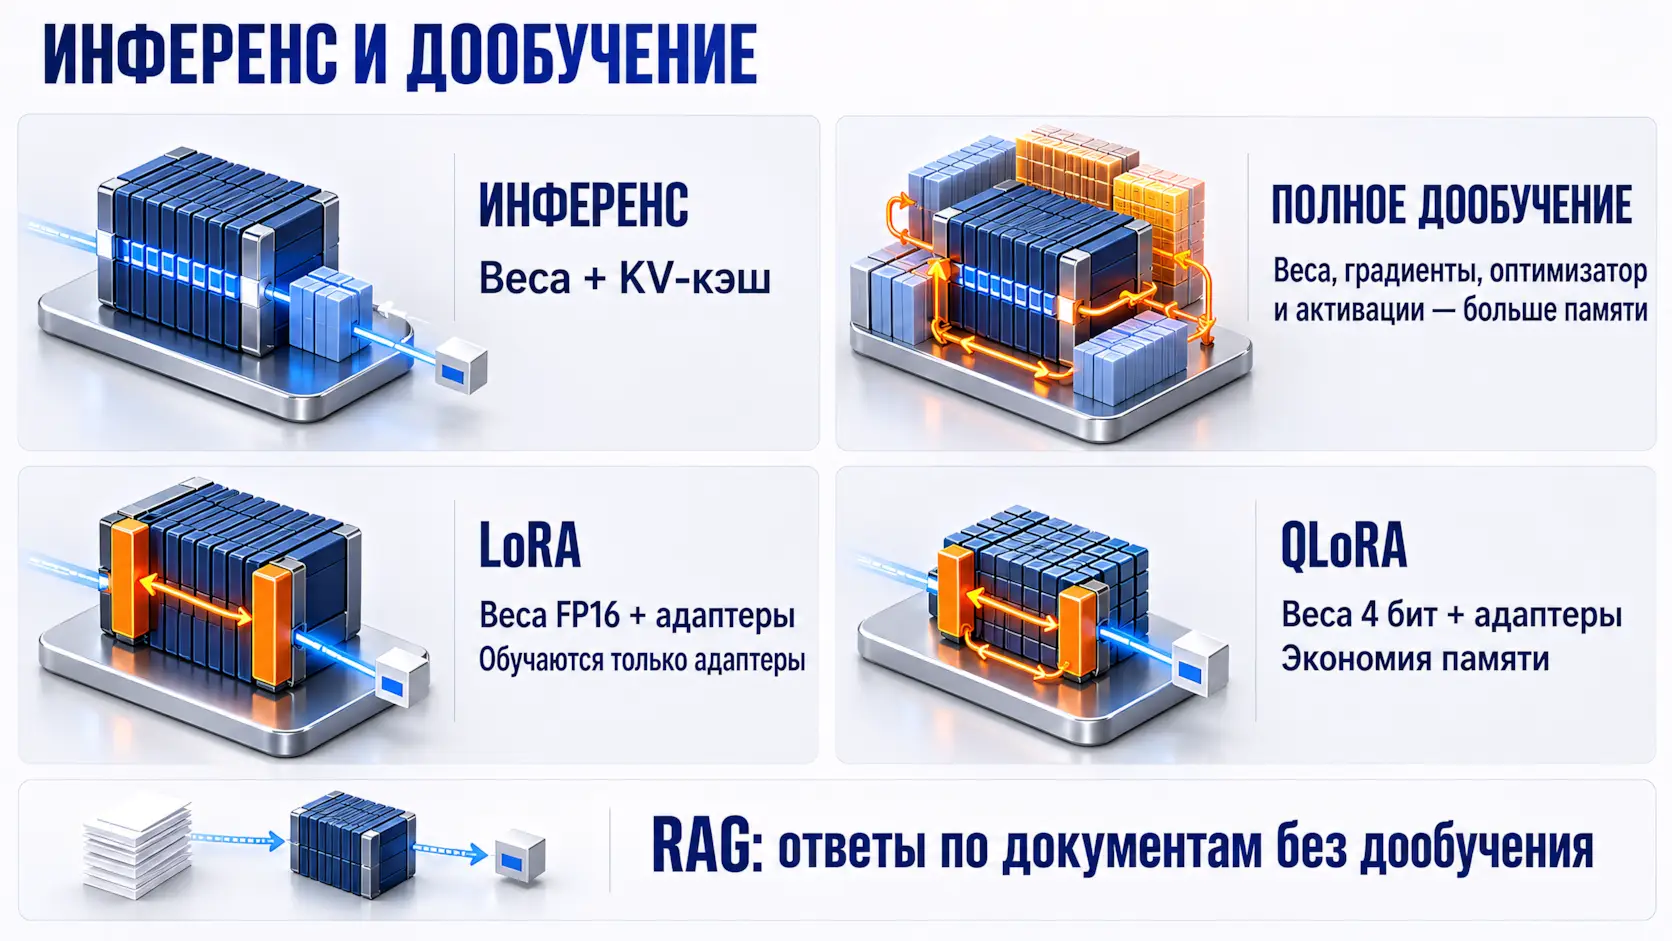
При инференсе видеокарта хранит только веса и кэш. При полном дообучении к ним добавляются градиенты, копия весов в повышенной точности и состояния оптимизатора. С оптимизатором Adam в смешанной точности это около 16 байт на параметр – в восемь раз больше, чем веса в FP16, и еще не считая активаций, которые зависят от длины примеров и размера батча.
| Задача | Память на параметр | Модель 8B | Модель 70B |
|---|---|---|---|
| Инференс в FP16 | 2 байта + кэш | от 16 ГБ | от 140 ГБ |
| Полное дообучение | около 16 байт + активации | от 130 ГБ | от 1,1 ТБ |
| LoRA | веса в FP16 + небольшие адаптеры | от 20 ГБ | от 150 ГБ |
| QLoRA | веса в 4 битах + адаптеры | от 8 ГБ | от 48 ГБ |
Практический вывод: полное дообучение большой модели – задача для кластера из нескольких серверов. Большинству компаний достаточно LoRA или QLoRA: обучается небольшая добавка к модели, а основные веса не меняются. QLoRA позволяет дообучать модель 70B на одной карте с 80 ГБ памяти. А если модель должна лишь отвечать по внутренним документам, дообучение часто не нужно вовсе: хватает поиска по базе знаний (RAG), а железо считается как для инференса.
Одна видеокарта или несколько
Если модель с кэшем не помещается в одну карту, ее делят между несколькими. Способов два:
- Тензорный параллелизм. Каждый слой делится между картами, и они обмениваются данными на каждом шаге. Нужна быстрая связь между GPU внутри сервера, иначе карты больше ждут друг друга, чем считают.
- Конвейерный параллелизм. Карты получают разные группы слоев и передают результат по цепочке. К скорости связи менее требователен, но увеличивает задержку ответа.
Внутри одного сервера обычно используют тензорный параллелизм, между серверами – конвейерный. Для тензорного параллелизма важна связь между картами: шина PCIe 5.0 x16 дает около 64 ГБ/с в каждую сторону, а специализированные межкарточные интерфейсы – в разы больше. Поэтому при выборе сервера смотрите не только на число карт, но и на то, как они соединены между собой.
Как оценить скорость ответа
При генерации каждого токена модель читает из памяти все свои веса. Поэтому скорость одного потока ограничена пропускной способностью видеопамяти, а не вычислительной мощностью. Грубая оценка верхней границы:
Токенов в секунду на один поток ≈ пропускная способность памяти / размер весов
Например, модель на 70 ГБ в INT8 на карте с пропускной способностью около 3 ТБ/с даст не больше 40 токенов в секунду на одного пользователя, на практике – меньше. Зато при одновременной работе нескольких пользователей веса читаются один раз на весь батч, поэтому при небольшой нагрузке скорость на каждого падает незначительно, пока хватает памяти под KV-кэш. Для многопользовательского сервиса объем памяти под кэш часто важнее вычислительной мощности карты.
Из формулы следует и другое: у ускорителей с памятью HBM пропускная способность обычно 2–5 ТБ/с, у карт с GDDR – примерно 1–1,8 ТБ/с. Поэтому при одинаковом объеме памяти карты с HBM генерируют текст заметно быстрее. А время до первого токена зависит уже от вычислительной мощности: перед ответом модель обрабатывает весь входной текст. Поэтому в RAG, где в запрос попадают длинные фрагменты документов, пользователь дольше ждет начала ответа, даже если сама генерация идет быстро.
Что еще нужно серверу, кроме GPU
✔ Оперативная память. При загрузке и конвертации модели веса часто проходят через ОЗУ. Рабочее правило – оперативной памяти сервера не меньше суммарной видеопамяти. Для дообучения с выгрузкой состояний оптимизатора в ОЗУ нужно заметно больше.
✔ Процессоры. При инференсе они редко становятся узким местом, но на подготовке данных для обучения и индексации документов для RAG загрузка процессоров высокая. Важно и число линий PCIe: каждой карте нужен полноценный слот PCIe x16.
✔ Локальные диски. От них зависит, как быстро модель запускается после перезагрузки или смены версии. Веса на 140 ГБ с NVMe-диска на 3 ГБ/с загрузятся примерно за минуту, а по сети 10 Гбит/с – около двух минут.
✔ Хранилище для данных и чекпоинтов. При дообучении система регулярно сохраняет состояние модели. Чекпоинт полного дообучения с состояниями оптимизатора занимает почти столько же, сколько память под обучение: для модели 70B это около терабайта за одно сохранение. Пока чекпоинт пишется, видеокарты простаивают, поэтому скорость записи хранилища напрямую влияет на время обучения. Для таких задач используют all-flash СХД на NVMe – например, TATLIN.AFA.
✔ Сеть между серверами. Пока модель работает в пределах одного сервера, достаточно обычной сети для доступа пользователей и хранилища. Когда обучение идет на нескольких серверах, между ними нужен канал на сотни гигабит в секунду с поддержкой RDMA, иначе карты большую часть времени ждут данные.
Пример расчета: корпоративный ассистент на 20 одновременных запросов
Задача: ассистент отвечает на вопросы сотрудников по внутренним документам через RAG. Одновременно до 20 запросов, в каждом до 8 тысяч токенов – вопрос и найденные фрагменты документов.
Вариант 1: модель 70B в FP8.
| Составляющая | KV-кэш в FP16 | KV-кэш в FP8 |
|---|---|---|
| Веса | 70 ГБ | 70 ГБ |
| Активации и буферы (оценка) | около 8 ГБ | около 8 ГБ |
| KV-кэш: 20 запросов × 8K токенов | около 54 ГБ | около 27 ГБ |
| Итого | около 132 ГБ | около 105 ГБ |
| Доступно на двух картах по 80 ГБ при резерве 10% | 144 ГБ | 144 ГБ |
| Предел одновременных запросов по 8K | около 24 | почти 50 |
С кэшем в FP16 двадцать запросов помещаются, но запас – всего четыре запроса, и двадцать пятый пользователь уже встанет в очередь. С кэшем в FP8 те же две карты обслужат почти 50 одновременных запросов. Если планируется контекст 32K или рост числа пользователей, закладывайте четыре карты.
Вариант 2: модель 8B в FP16.
Веса 16 ГБ, активации и буферы около 3 ГБ, KV-кэш на те же 20 запросов – около 21 ГБ. Итого около 40 ГБ при 43 доступных на карте на 48 ГБ – одной карты хватает. Для поиска по документам и простых ответов модели такого размера часто достаточно, а железо обходится в разы дешевле.
Расчет на бумаге стоит проверить пилотом: запустить выбранную модель на реальных запросах и замерить потребление памяти и скорость ответа при расчетной нагрузке.
Как перевести расчет в конфигурацию сервера
Когда потребность в памяти посчитана, ее нужно превратить в требования к серверу. Именно на этом шаге чаще всего ошибаются.
| Что получилось в расчете | Что это значит для сервера |
|---|---|
| Суммарный объем видеопамяти | Число и объем ускорителей. Меньше карт с большим объемом памяти обычно лучше, чем много карт с малым: меньше обмена данными между ними |
| Модель не помещается в одну карту | Нужны 2, 4 или 8 карт: при тензорном параллелизме их число должно делить число голов внимания модели. Каждой карте – слот PCIe x16 и быстрая связь с остальными |
| Планируется рост пользователей или контекста | Шасси со свободными слотами: дешевле доставить карты в тот же сервер, чем покупать второй |
| Несколько моделей или частая смена версий | Локальные NVMe-диски под веса и ОЗУ не меньше суммарной видеопамяти |
| Нужно дообучение | Быстрое хранилище для датасетов и чекпоинтов и сеть на сотни гигабит для нескольких серверов |
| Несколько мощных ускорителей в одном корпусе | Питание и охлаждение: сервер с восемью ускорителями потребляет несколько киловатт. Заранее проверьте допустимую мощность на стойку и теплоотвод |
Что подготовить для подбора сервера
- какую модель или класс моделей планируете запускать и в какой точности;
- сколько пользователей будет работать одновременно сейчас и через год;
- какая длина запросов нужна в реальных сценариях;
- нужно ли дообучение или достаточно RAG;
- где будет стоять сервер: свободное место в стойке, доступная мощность и охлаждение.
С этими данными можно сразу рассчитать конфигурацию. Под такие задачи мы собираем сервер для ИИ YADRO G4208P G3: подбираем число ускорителей, память и диски под вашу модель и нагрузку.
Частые ошибки при расчете
- Считают только веса. Модель запускается, но падает или тормозит, как только приходят несколько пользователей с длинными запросами.
- Включают максимальный контекст «на всякий случай». 128K токенов на запрос для модели 70B – это 40 ГБ кэша на одного пользователя. Ограничьте контекст реальными сценариями.
- Планируют полное дообучение там, где хватит RAG или LoRA. Разница в железе – в разы.
- Забывают про хранилище. При дообучении медленная запись чекпоинтов останавливает дорогие видеокарты.
- Не закладывают рост. Пилот на пять человек через полгода превращается в сервис на сотню, а свободных слотов под карты в сервере нет.
Частые вопросы
1. Какой сервер нужен для нейросети?
Зависит от размера модели и числа пользователей. Для моделей до 8B и небольшой команды хватает сервера с одной картой на 48 ГБ. Для моделей 70B и десятков одновременных запросов нужен сервер на несколько ускорителей по 80 ГБ с быстрой связью между ними, ОЗУ не меньше суммарной видеопамяти и NVMe-дисками под веса. Для дообучения к этому добавляются быстрое хранилище и сеть между серверами.
2. Сколько видеопамяти нужно для модели 7B?
Около 14 ГБ под веса в FP16 или 7 ГБ в INT8, плюс примерно 1 ГБ на каждый одновременный запрос с контекстом 8K у моделей с GQA. Для одного-двух пользователей хватает карты на 24 ГБ.
3. Можно ли запустить модель 70B на одной видеокарте?
В INT4 веса занимают около 40 ГБ, так что модель помещается в карту на 48 или 80 ГБ. Но на 48 ГБ почти не остается места под KV-кэш, а качество ответов в 4 битах ниже. Для сервиса на несколько пользователей обычно берут две карты по 80 ГБ и FP8.
4. Что такое KV-кэш?
Это промежуточные значения внимания для уже обработанных токенов. Модель хранит их, чтобы не пересчитывать весь текст на каждом шаге. Объем растет пропорционально длине контекста и числу одновременных запросов.
5. Чем INT4 отличается от FP16 на практике?
Веса занимают примерно в четыре раза меньше памяти, и генерация идет быстрее, потому что из памяти читается меньше данных. Цена – небольшая потеря качества, которая заметнее на сложных задачах. Перед запуском стоит сравнить ответы на своих задачах.
6. Сколько памяти нужно для дообучения?
При полном дообучении – около 16 байт на параметр без учета активаций, то есть от 130 ГБ для модели 8B. LoRA снижает потребность примерно до размера весов с небольшим запасом, а QLoRA позволяет дообучить модель 70B на одной карте на 80 ГБ.
7. Нужна ли видеокарта для RAG?
Для генерации ответа – да, требования те же, что для обычного инференса. Индексация документов и поиск по базе знаний нагружают в основном процессоры и хранилище, а модель для эмбеддингов небольшая и обычно работает на той же видеокарте.