Мы используем cookies для корректной работы сайта и подключаем аналитику (Яндекс.Метрика), чтобы понимать, что улучшать
Как рассчитать ресурсы кластера виртуализации: CPU, RAM, хранилище и N+1
Главный принцип расчета – кластер должен выдержать отказ хоста
Кластер виртуализации нельзя рассчитывать только по сумме vCPU, оперативной памяти и терабайт виртуальных дисков.
Главная проверка начинается после расчета ресурсов: что произойдет, если один из хостов станет недоступен?
При N+1 оставшиеся узлы должны вместить необходимые виртуальные машины и обеспечить им требуемые процессорные ресурсы, оперативную память и производительность дисковой подсистемы.
Поэтому расчет строится последовательно:
нагрузка → процессор → оперативная память → хранилище → отказ одного хоста → проверка N+1
Какие данные нужны перед расчетом
Для действующей инфраструктуры исходные данные лучше получать из мониторинга, а не только из настроек виртуальных машин.
| Ресурс | Что собрать |
|---|---|
| Процессор | vCPU, фактическую загрузку и пики |
| Оперативная память | Выделенную и реально используемую память |
| Хранилище | Занятое место и темп роста |
| Дисковая нагрузка | IOPS, пропускную способность и задержки |
| Виртуальные машины | Количество, критичность и ограничения размещения |
| Развитие | Новые ВМ и увеличение существующих ресурсов |
| Отказоустойчивость | Сколько отказов должен выдерживать кластер |
Период измерений должен включать характерные пики: закрытие месяца, резервное копирование, пакетные задания, массовые обновления и другие ресурсоемкие операции.
Если проект новый и статистики еще нет, используют требования приложений, планируемое количество ВМ и пользователей, рекомендации производителей ПО и расчетный профиль нагрузки.
Процессор: считать нагрузку, а не количество vCPU
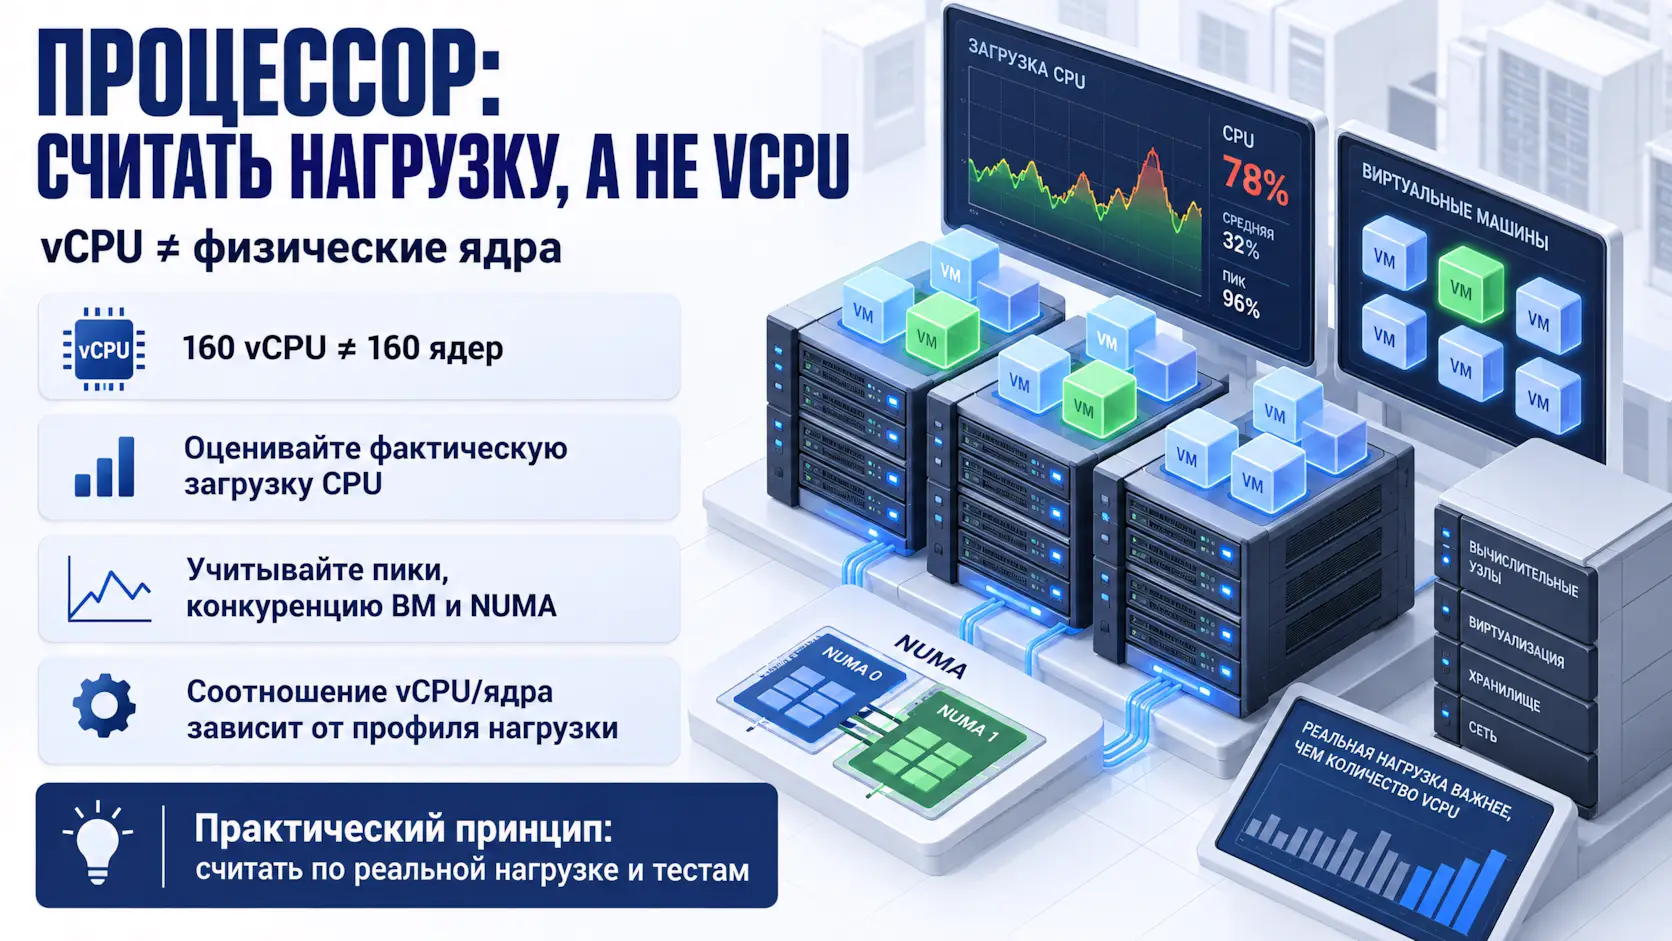
Количество выделенных виртуальных процессоров vCPU само по себе не показывает, сколько физических процессорных ресурсов требуется кластеру.
Если виртуальным машинам суммарно назначено 160 vCPU, это не означает ни необходимость 160 физических ядер, ни возможность автоматически поделить это число на 2, 4 или 8.
Гипервизор распределяет физическое процессорное время между виртуальными машинами, поэтому количество выделенных vCPU может превышать количество физических ядер. Но универсального безопасного соотношения для любого кластера нет.
Для действующей инфраструктуры нужно анализировать:
- фактическую загрузку процессоров;
- пиковые периоды;
- конкуренцию ВМ за процессорное время;
- наиболее нагруженные ВМ;
- ограничения NUMA.
Практический принцип: отношение vCPU к физическим ядрам должно определяться профилем нагрузки, а не задаваться заранее ради уменьшения количества серверов.
Если новые серверы используют другое поколение процессоров, одного сравнения количества ядер тоже недостаточно. Нужно учитывать разницу в производительности по результатам тестов, измерений или испытаний на характерной нагрузке.
Почему важен NUMA
Для крупных виртуальных машин отдельно проверяют, как их процессорные ресурсы и память соотносятся с NUMA-топологией физического сервера.
Если ВМ выходит за пределы одного NUMA-узла, ей может потребоваться обращаться к памяти другого узла. Для чувствительных к задержкам приложений это способно снизить производительность.
Поэтому важно проверить не только общую мощность кластера, но и может ли самая крупная ВМ корректно разместиться на одном из физических хостов.
Оперативная память: считать состояние после отказа
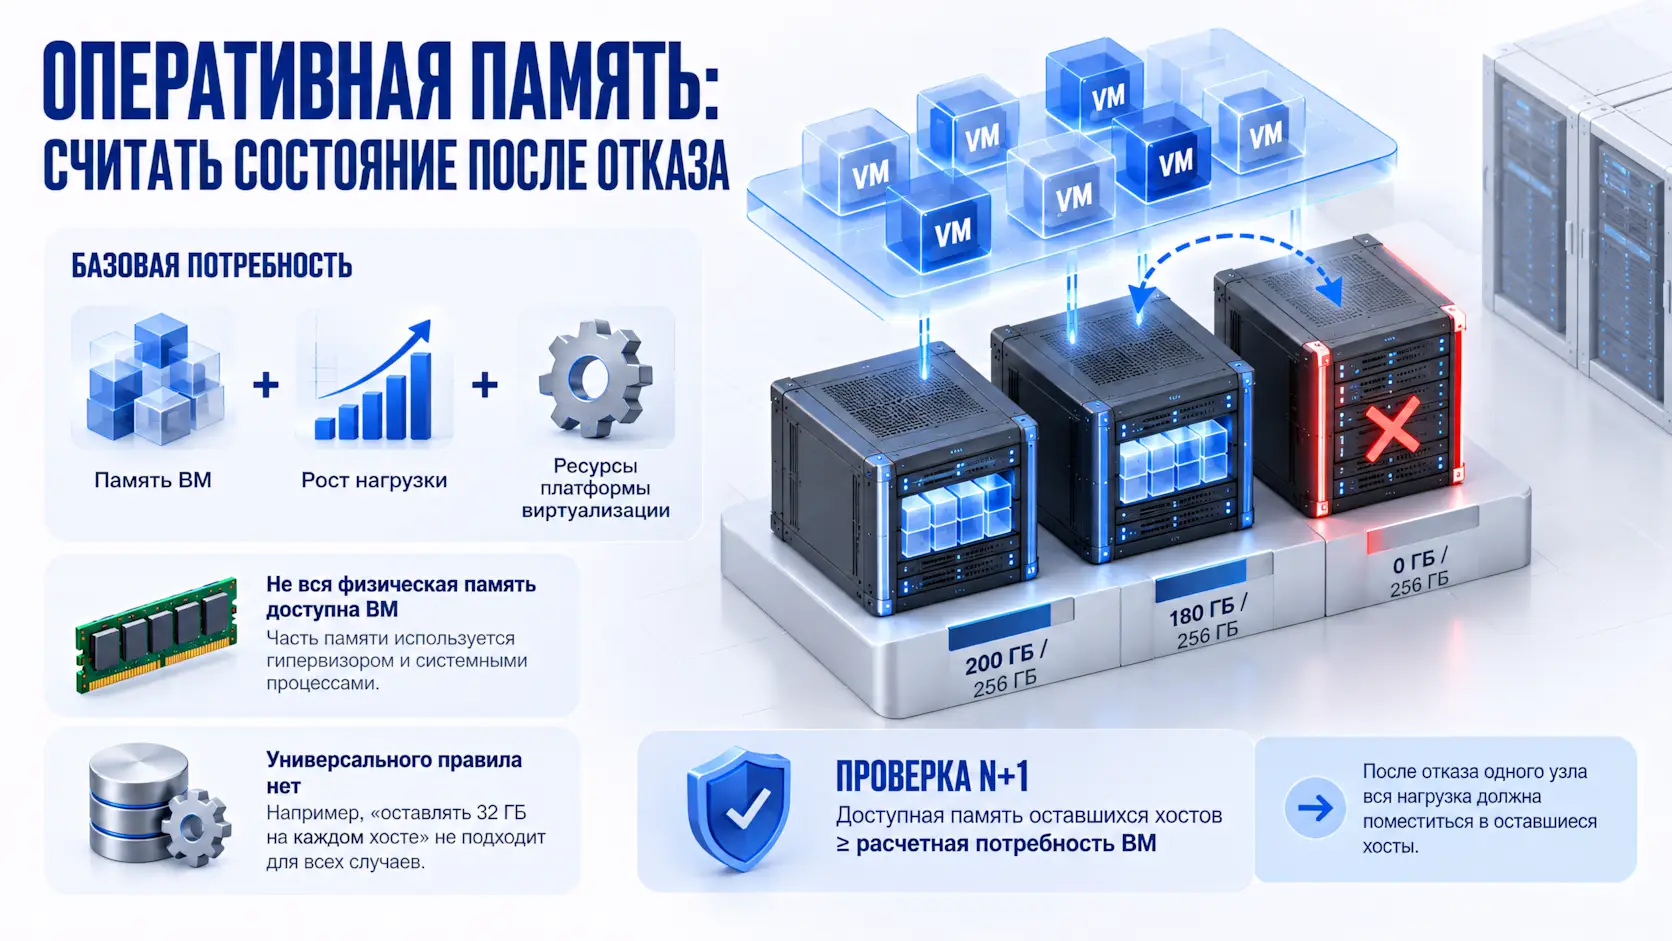
Базовая потребность определяется как:
память ВМ + рост нагрузки + ресурсы самой платформы виртуализации
Универсального правила вроде «оставлять 32 ГБ на каждом хосте» нет.
Часть физической памяти используется гипервизором, управляющими компонентами и системными процессами. Поэтому в расчет нужно брать память, реально доступную виртуальным машинам в конкретной конфигурации.
Для N+1 выполняется проверка:
доступная память оставшихся хостов ≥ расчетная потребность ВМ
Если кластер состоит из трех одинаковых узлов, нужно убедиться, что после потери одного вся необходимая нагрузка помещается в два оставшихся.
Механизмы динамического распределения памяти могут повышать эффективность ее использования, но для критичной инфраструктуры их не стоит рассматривать как замену достаточному объему физической RAM.
Как рассчитать количество хостов N+1
Для одинаковых серверов отдельно определяют ограничение по процессору и памяти.
После приведения процессорной нагрузки к производительности целевых серверов:
NCPU = ceil(CPUрасч / CPU одного хоста)
По памяти:
NRAM = ceil(RAMрасч / RAM, доступная ВМ на одном хосте)
Для рабочей нагрузки принимается большее значение:
Nраб = max(NCPU, NRAM)
Для отказа одного вычислительного узла:
Nитого = Nраб + 1
Это расчет вычислительной емкости N+1, а не универсальная формула построения отказоустойчивого кластера. Требования к минимальному количеству узлов, кворуму и дополнительным компонентам зависят от конкретной платформы виртуализации.
Пример:
| Параметр | Значение |
|---|---|
| Расчетная CPU-нагрузка | 50 условных ядер целевого CPU |
| Расчетная RAM | 820 ГБ |
| CPU одного хоста | 32 ядра |
| RAM, доступная ВМ на одном хосте | 480 ГБ |
По процессору: ceil(50 / 32) = 2 хоста
По памяти: ceil(820 / 480) = 2 хоста
Для рабочей нагрузки достаточно двух серверов. Для N+1 требуется 3 хоста.
После отказа одного узла остаются 64 ядра и 960 ГБ памяти при расчетной потребности 50 ядер и 820 ГБ.
Но необходимо дополнительно проверить, смогут ли крупные ВМ разместиться на двух оставшихся серверах с учетом NUMA, зарезервированных ресурсов и правил размещения.
Комментарий инженеров СИНТО. N+1 нужно проверять моделированием потери хоста. Если после его исключения хотя бы одна критичная ВМ не может запуститься или получает недостаточно ресурсов, расчет N+1 не выполнен.
Для кластера из неодинаковых серверов простое правило «добавить один хост» применять нельзя. Нужно моделировать потерю наиболее значимого по ресурсам узла.
Хранилище: емкость и производительность считаются отдельно
Для дисковой подсистемы одного показателя в терабайтах недостаточно.
Нужно ответить на два вопроса:
Хватит ли полезной емкости?
Хватит ли производительности?
Расчет емкости
Учитываются:
- фактически занятые данные;
- прогноз роста;
- снимки виртуальных машин;
- служебные данные платформы;
- схема RAID, репликации или кодирования с избыточностью;
- технологический запас.
Ориентироваться нужно на полезную емкость, доступную для размещения данных, а не на сумму номиналов установленных дисков.
Например, 40 ТБ SSD не означают 40 ТБ пространства для виртуальных машин. Итоговая полезная емкость зависит от схемы защиты данных и архитектуры хранилища.
Тонкое выделение дискового пространства не увеличивает физическую емкость
При тонком выделении виртуальным дискам можно логически назначить больше пространства, чем они занимают физически в данный момент.
Но реальная емкость хранилища от этого не увеличивается.
Поэтому необходимо контролировать:
фактически занято → скорость роста → реально свободно
Если физическое пространство закончится, виртуальные машины могут столкнуться с ошибками ввода-вывода.
Производительность хранилища
Для расчета недостаточно знать только IOPS.
Следует анализировать:
- IOPS;
- пропускную способность, МБ/с или ГБ/с;
- задержку;
- соотношение чтения и записи;
- пиковые периоды.
Желательно анализировать общую нагрузку на хранилище, а не просто складывать максимальные значения отдельных ВМ: пики у них могут происходить в разное время.
Особое внимание стоит уделить совместным нагрузкам, например когда одновременно работают базы данных, резервное копирование, антивирусное сканирование и фоновые задания.
Что происходит с хранилищем при отказе хоста
Здесь расчет зависит от архитектуры.
Общая внешняя СХД
При отказе вычислительного сервера физическая емкость внешней СХД обычно не уменьшается.
Но отдельно проверяется отказоустойчивость самой системы хранения:
- контроллеров;
- путей доступа;
- сети хранения;
- дисков;
- коммутаторов.
Гиперконвергентная инфраструктура
Если вычислительные ресурсы и хранилище находятся на одних и тех же узлах, отказ сервера одновременно уменьшает:
- вычислительную мощность;
- доступную емкость хранения;
- суммарную производительность дисковой подсистемы.
После отказа может начаться восстановление реплик или перераспределение данных, что создает дополнительную фоновую нагрузку.
Поэтому для гиперконвергентной инфраструктуры N+1 нельзя рассчитывать только по процессору и памяти. Нужно дополнительно проверить емкость и производительность хранилища после отказа узла и во время восстановления данных.
Что еще может нарушить N+1
Достаточный запас CPU и RAM еще не гарантирует, что все ВМ смогут автоматически запуститься после отказа.
Нужно проверить:
- reservations CPU и RAM;
- affinity и anti-affinity;
- NUMA;
- локальные диски;
- PCI passthrough;
- SR-IOV;
- vGPU;
- доступность сетей и storage;
- лицензионные ограничения;
- правила самой HA-платформы.
Например, в актуальной документации РЕД ВИРТ для миграции ВМ прямо указано требование достаточных CPU и RAM на целевом хосте. То есть наличие хоста в кластере само по себе не означает возможность принять конкретную виртуальную машину.
Что еще может нарушить N+1
Достаточного количества процессорных ресурсов и памяти недостаточно, если отдельную ВМ нельзя разместить на оставшихся серверах.
Проверяют:
- зарезервированные процессорные ресурсы и память;
- правила совместного и раздельного размещения ВМ;
- NUMA;
- локальные диски;
- прямой проброс устройств;
- SR-IOV;
- vGPU;
- доступность сетей и хранилищ;
- лицензионные ограничения;
- правила отказоустойчивости конкретной платформы.
То есть:
«суммарных ресурсов достаточно» и «все необходимые ВМ смогут запуститься» – не всегда одно и то же.
Что проверить перед закупкой серверов
| Проверка | Что должно быть известно |
|---|---|
| Процессор | Фактическая и пиковая потребность |
| Оперативная память | Потребность ВМ и доступная память после отказа |
| Крупные ВМ | Возможность размещения на оставшихся хостах |
| Емкость хранилища | Полезная ёмкость и прогноз роста |
| Производительность хранилища | IOPS, пропускная способность и задержки |
| N+1 | Ресурсы после отказа хоста |
| Отказоустойчивость | Кворум и требования платформы |
| Сеть | Пропускная способность и резервирование |
| Рост | Ресурсы для будущих ВМ |
Такой расчет стоит выполнять до выбора конкретной модели сервера и платформы, особенно при консолидации инфраструктуры, обновлении оборудования или проектировании виртуализации серверов.
Часто задаваемые вопросы
Какое отношение vCPU к физическим ядрам использовать?
Универсального значения нет. Для существующей инфраструктуры соотношение определяют по фактической нагрузке. Для нового проекта – по профилю приложений и результатам испытаний.
Значения 2:1, 4:1 или 8:1 нельзя использовать как универсальное правило.
Сколько vCPU можно выделить на одно физическое ядро?
Это зависит от нагрузки и гипервизора. Если виртуальные машины большую часть времени используют небольшую долю выделенных процессорных ресурсов, отношение vCPU к физическим ядрам может быть выше. Для постоянно нагруженных баз данных и вычислительных систем допустимое значение обычно будет ниже.
Как рассчитать N+1?
Для одинаковых хостов сначала определяют количество серверов, необходимое для рабочей нагрузки по процессору и памяти. Затем добавляют ресурс одного узла и проверяют состояние после его отказа.
Для неодинаковых серверов моделируют потерю конкретного хоста, в том числе наиболее мощного.
Нужно ли держать один сервер полностью свободным?
Нет. Нагрузка может быть распределена между всеми хостами. Главное – чтобы после отказа одного узла ресурсов оставшихся серверов хватало для необходимых ВМ.
Можно ли выделять виртуальным машинам больше памяти, чем физически установлено?
Некоторые гипервизоры поддерживают динамическое распределение и переподписку памяти.
Но для критичных систем такую память нельзя автоматически считать равноценной установленной физической RAM. Нужно учитывать поведение платформы при ее дефиците.
Какой запас ресурсов оставлять?
Универсального процента нет. Запас определяется ростом количества ВМ, увеличением существующих нагрузок, требованиями N+1/N+2 и возможностями выбранных серверов.
Как рассчитать хранилище для кластера виртуализации?
Нужно проверить две независимые характеристики:
- полезную емкость – сколько данных реально можно разместить;
- производительность – какие IOPS, пропускную способность и задержки обеспечивает хранилище.
Для гиперконвергентной инфраструктуры обе характеристики дополнительно проверяют после отказа узла и при восстановлении данных.
Достаточно ли трех хостов для N+1?
Не всегда. Три одинаковых сервера могут обеспечить N+1 по вычислительным ресурсам, если двух оставшихся достаточно для всей расчетной нагрузки. Но требования к кворуму, хранилищу, сети и отказоустойчивости зависят от конкретной платформы.
Вывод
Для расчета кластера виртуализации недостаточно сложить vCPU, оперативную память и объем виртуальных дисков.
Нужно последовательно проверить:
процессор → оперативная память → полезная емкость хранилища → производительность хранилища → отказ хоста
Главный критерий N+1: после потери одного расчетного узла оставшаяся инфраструктура должна обеспечивать необходимую нагрузку с требуемой производительностью.
Только после такой проверки имеет смысл выбирать количество и конфигурацию физических серверов.