Мы используем cookies для корректной работы сайта и подключаем аналитику (Яндекс.Метрика), чтобы понимать, что улучшать
S3-хранилище на нескольких площадках: что произойдет при отказе одного ЦОД

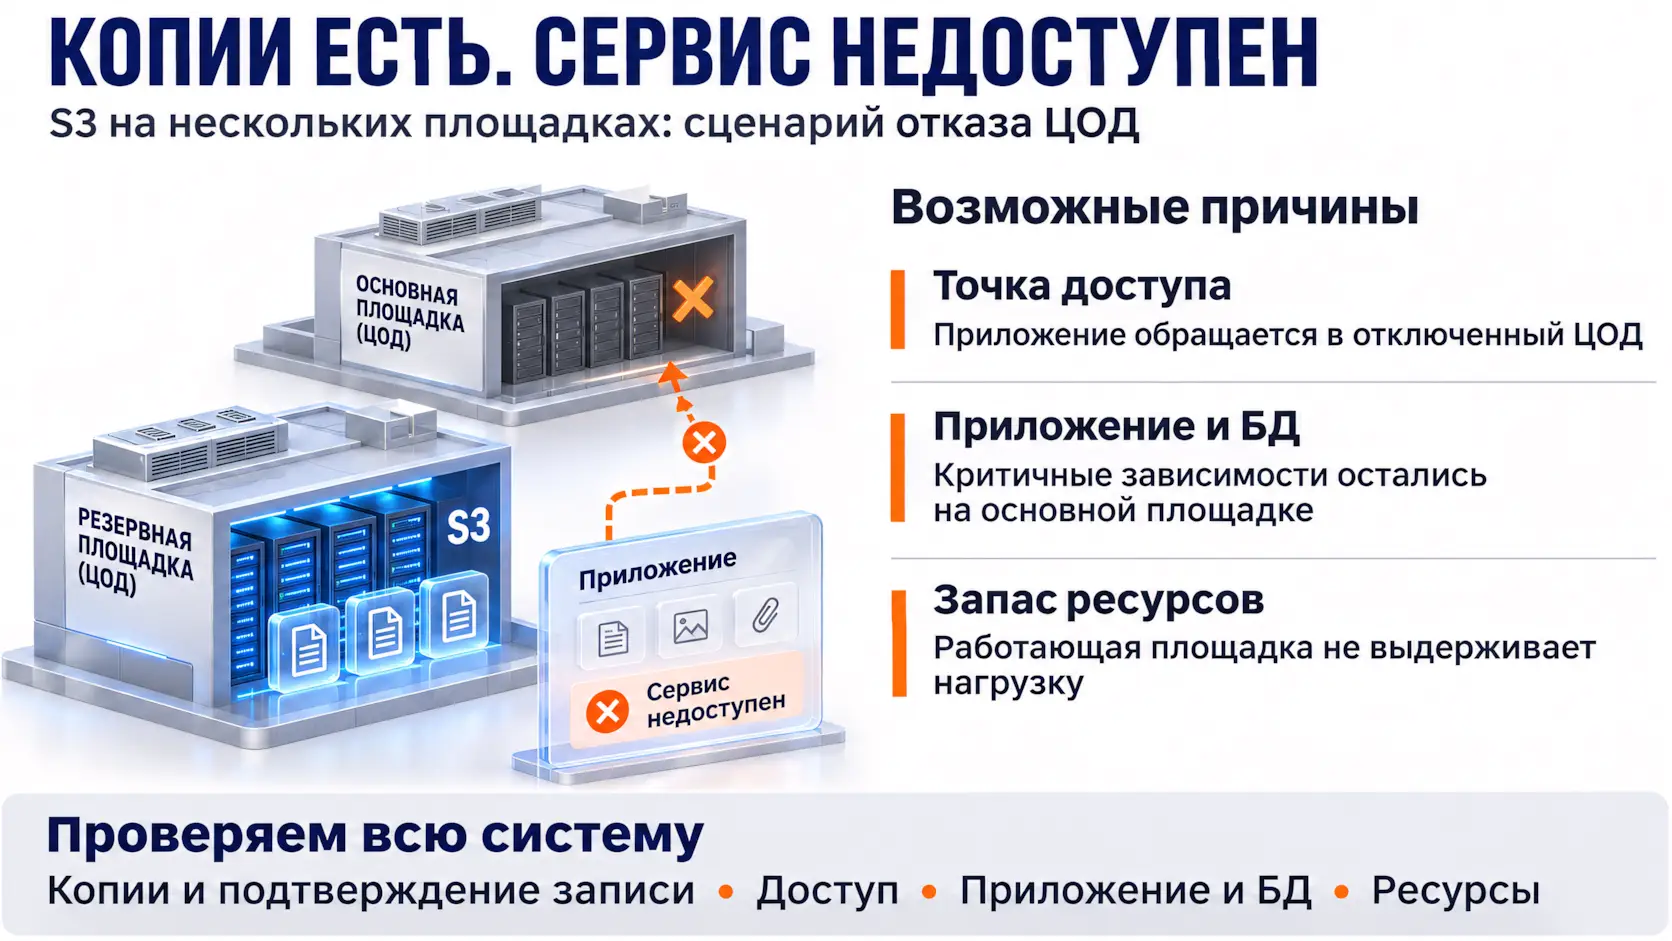
Основной дата-центр стал недоступен. Копии документов находятся на другой площадке, серверы хранения работают. Но пользователи не могут открыть вложения, а загрузка новых файлов завершается ошибкой.
Такой сценарий возможен даже при исправной репликации. Объекты сохранились, однако приложение продолжает обращаться к отключенной точке доступа. Или его база данных осталась в основном ЦОД. Или оставшаяся площадка принимает запросы, но не выдерживает дополнительную нагрузку.
S3-хранилище на нескольких площадках может сохранить данные и продолжить обслуживание после отказа одного ЦОД. Результат зависит от размещения копий, условий подтверждения записи, доступности приложений и ресурсов работающих площадок.
Проследим, что происходит после аварии: от последней загрузки файла до восстановления штатной защиты.
Первая проверка: где находится последняя подтвержденная запись
Совместимость с S3 описывает интерфейс взаимодействия приложения с объектным хранилищем. Из нее нельзя определить, сколько копий объекта создано, в каких ЦОД они находятся и что произойдет при разрыве связи.
Представим условный сценарий:
- В 12:00:00 площадка А подтвердила успешную загрузку документа.
- В 12:00:02 площадка А стала недоступна.
Передача документа на площадку Б к этому моменту еще не завершилась.
При асинхронной репликации такая последовательность возможна: подтверждение локальной записи и появление удаленной копии происходят в разное время. Последний документ может отсутствовать на работающей площадке.
Это еще не обязательно означает безвозвратную потерю. Если площадка А восстановится и данные на ней сохранятся, объект можно будет получить позднее. Если единственный актуальный экземпляр утрачен, восстановить его средствами репликации уже не получится.
В системах с поддержкой синхронной межплощадочной записи условие успешной операции может включать сохранение данных в нескольких ЦОД. Тогда нужно заранее определить поведение при недоступности одной из обязательных площадок: сможет ли система продолжать запись и с каким уровнем защиты.
Главный вопрос к проекту звучит конкретно: где уже сохранен объект к моменту, когда приложение получило успешный ответ?
Для асинхронной схемы дополнительно измеряют отставание репликации под рабочей нагрузкой. Проверка на почти пустом хранилище не показывает, что произойдет во время массовой загрузки документов или передачи крупных архивов.

Объекты сохранились. Почему приложение все еще не работает?
Следующий этап – обеспечить путь от пользователя до сохранившихся данных.
У приложения обычно есть адрес подключения к S3 – endpoint. Если этот адрес ведет только в отказавший ЦОД, наличие удаленных копий не восстановит доступ автоматически. Нужны предусмотренные архитектурой механизмы маршрутизации или переключения клиента.
При использовании DNS проверяют время обновления записей и поведение клиентского кеша. При использовании балансировщика – его собственную отказоустойчивость и проверки работоспособности S3-сервиса.
Но успешный запрос к хранилищу еще не подтверждает работу приложения.
Например, вложения находятся на двух площадках, а база данных с карточками документов – только на одной. После ее отказа файлы физически доступны, однако пользователь не может найти нужный документ. Аналогичная зависимость может возникнуть от службы авторизации или системы управления ключами шифрования, если приложение использует ее.
Поэтому приемочный сценарий должен проходить всю цепочку:
вход пользователя → поиск документа → открытие вложения → загрузка нового файла → повторное открытие.
Отдельно проверяют операции, необходимые приложению: чтение, запись, получение списка объектов, работу с версиями. Если сервис создает новые бакеты во время работы, эта операция тоже должна входить в программу испытаний.
Оставшаяся площадка принимает нагрузку
После восстановления доступа начинается более продолжительный этап: работа без одного ЦОД.
Рассмотрим расчетный пример. Две площадки обслуживают по 1 000 запросов в секунду. Если после отказа одной из них весь поток направляется на оставшуюся, ей потребуется обработать 2 000 запросов в секунду при прежнем составе операций и размерах объектов.
Это требование к аварийному режиму. Два одинаковых сервера или два одинаковых хранилища сами по себе его выполнение не подтверждают.
Для проверки нужны исходные данные:
- соотношение чтения и записи;
- распределение размеров объектов;
- число одновременных подключений;
- допустимые задержки и доля ошибок;
- фоновая нагрузка от репликации и восстановления копий.
Среднее время ответа может скрыть проблему: большинство файлов открывается быстро, а часть запросов регулярно превышает таймаут приложения. Поэтому вместе со средним значением оценивают, например, p95 и p99 – задержку, в которую укладываются 95% и 99% запросов.
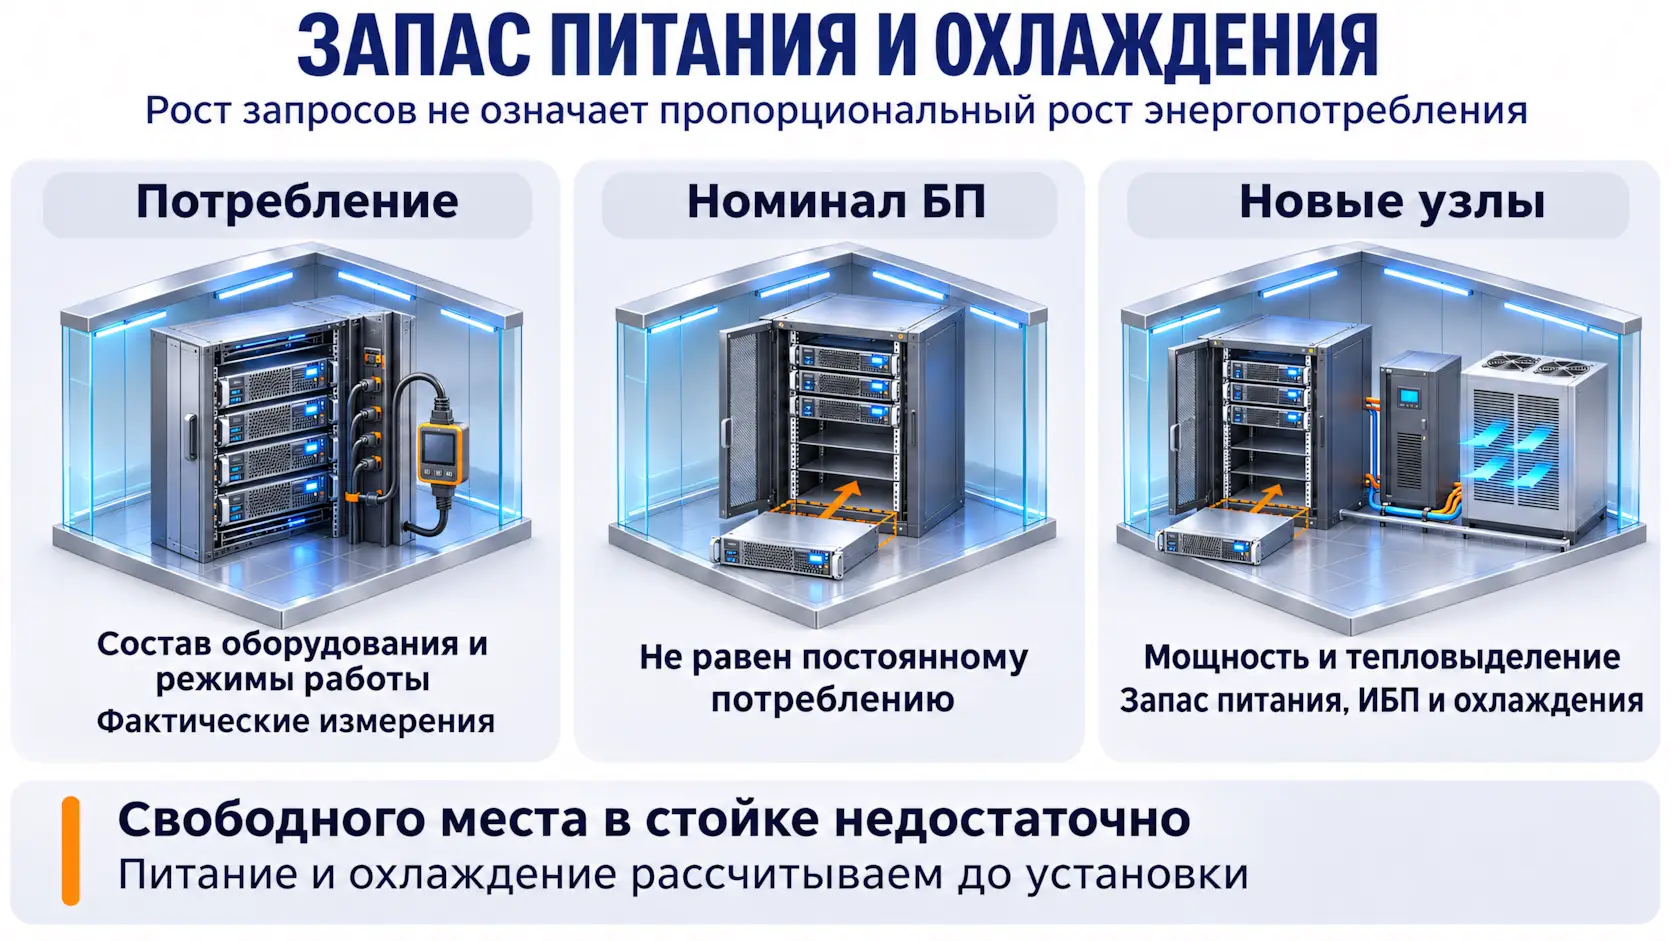
Требования распространяются и на инженерную инфраструктуру. Для согласованного аварийного режима проверяют мощность оборудования, загрузку линий питания, возможности ИБП и охлаждения.
Рост числа запросов не означает пропорционального роста потребления электроэнергии. Электрическую нагрузку определяют по составу оборудования, его режимам работы и измерениям. Номинал блока питания показывает его возможности, а не постоянное потребление сервера.
Если для приема нагрузки нужно включить дополнительные узлы, их мощность и тепловыделение учитывают заранее. Свободное место в стойках еще не подтверждает возможность установить оборудование.
Два или три ЦОД: сколько защиты останется после аварии
Рассмотрим простую схему с полными копиями: каждый объект имеет актуальный экземпляр на площадке А и на площадке Б.
После потери А экземпляр остается на Б. При этом локальная защита от отказов дисков или серверов может продолжать работать, но географического резерва для этого объекта уже нет.
Если актуальный экземпляр каждого объекта размещен в трех независимых ЦОД, после потери одного остаются две площадки с данными. Это дает дополнительный запас на период восстановления.
Однако наличие трех ЦОД в общей схеме не означает, что каждый объект записан во всех трех. Проверять нужно фактическую политику размещения. При использовании Erasure Coding оценивают, останется ли после потери целой площадки достаточно фрагментов для восстановления объекта.
Помимо данных, учитывают доступность метаданных и необходимых компонентов управления: сохранившиеся копии не устраняют зависимость от отказавшего узла, если архитектура требует его участия.
Один из вариантов построения распределенного хранения – YADRO TATLIN.OBJECT. Политики на уровне бакетов позволяют задавать количество копий, их размещение и условия подтверждения записи. В проекте эти настройки связывают с требованиями приложения и возможностями площадок.
Что проверить при разрыве связи между работающими ЦОД
Потерю межплощадочного соединения испытывают отдельно от отключения дата-центра. Оба ЦОД могут оставаться исправными и принимать клиентские запросы, но перестать обмениваться данными.
Заранее определяют, какие операции разрешены в каждой изолированной части системы, какие данные доступны локально и как обрабатываются изменения после восстановления связи. Возможность продолжать запись и правила согласования зависят от конкретной реализации и настроек.
Два канала также требуют проверки общей инфраструктуры: разные договоры с операторами еще не подтверждают разные кабельные трассы и независимые узлы связи.
Сколько времени займет восстановление копий
Возвращение питания и связи не завершает аварийный сценарий. Нужно восстановить предусмотренное размещение объектов, включая изменения, появившиеся во время отключения.
Оценим нижнюю границу времени передачи данных на условном примере.
Пусть требуется передать 10 ТБ по каналу 10 Гбит/с. Используем десятичные единицы:
10 × 10¹² байт × 8 ÷ 10 × 10⁹ бит/с = 8 000 секунд.
Это 2 часа 13 минут 20 секунд при непрерывном использовании всей указанной полосы, без учета накладных расходов и ограничений оборудования.
Если восстановлению можно выделить только 3 Гбит/с, расчетная нижняя граница увеличится примерно до 7 часов 24 минут.
Реальное время может оказаться больше. Его ограничивают чтение на источнике, запись на получателе, обработка метаданных, задержки сети и конкуренция с пользовательскими запросами. Если за это время появляются новые данные, которые также требуется реплицировать, объем работы увеличивается.
В расчете используются именно 10 ТБ передаваемых данных. Общая емкость хранилища может быть значительно больше, а объем восстановления зависит от характера отказа и механизмов системы.
Для проекта ЦОД это практический вопрос: как долго инфраструктура будет работать с уменьшенным запасом защиты и какую нагрузку она должна выдерживать в этот период?
Слишком медленное восстановление может потребовать изменения каналов, состава узлов или размещения данных. Простое увеличение емкости эту задачу не решает.
Как проверить готовность резервного ЦОД
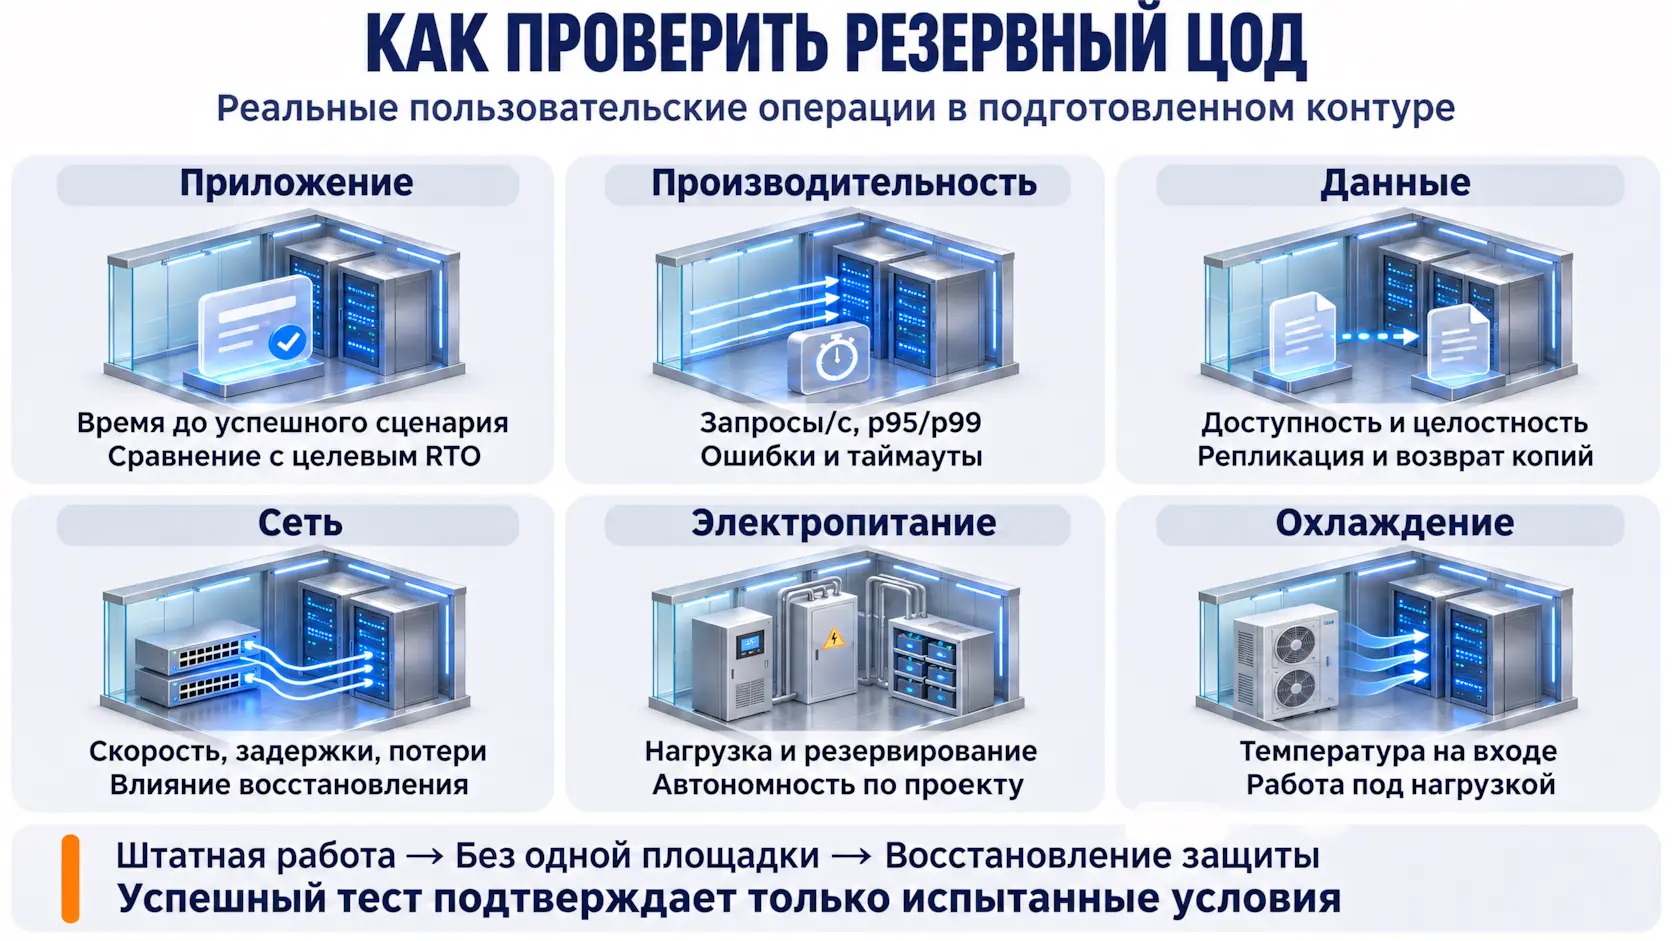
Программа испытаний должна воспроизводить согласованные отказы и проверять реальные пользовательские операции. Ее выполняют в подготовленном контуре, с определенными условиями остановки и возврата.
До испытания создают набор объектов с известными ключами, размерами и контрольными суммами. Во время теста отдельно регистрируют успешные загрузки, ошибки и таймауты. После переключения проверяют доступность объектов и сравнивают содержимое с исходными данными.
Таймаут требует отдельного разбора: сервер мог сохранить объект, хотя клиент не получил ответ. Повторная попытка должна обрабатываться с учетом логики приложения, ключей объектов и используемого версионирования.
Проверку проводят в трех состояниях: штатная работа, работа без одной площадки и восстановление защиты.
| Что проверяют | Что фиксируют в протоколе |
|---|---|
| Работу приложения | Время от начала отказа до успешного выполнения пользовательского сценария; сравнение с целевым RTO |
| Производительность | Выполненные запросы в секунду, состав операций, размеры объектов, p95/p99 задержек и долю ошибок |
| Данные и репликацию | Доступность подтвержденных записей, целостность тестовых объектов, отставание репликации и время восстановления требуемого размещения копий |
| Сеть | Полезную скорость передачи, задержки, потери пакетов и влияние восстановления на пользовательский трафик |
| Электропитание | Нагрузку на вводах, ИБП и линиях распределения; возможности согласованной схемы при отказе ее элемента |
| Охлаждение | Температуру воздуха на входе в оборудование и способность поддерживать проектные условия при расчетной нагрузке |
Для автономной работы дополнительно определяют время поддержки нагрузки от ИБП, порядок запуска ДГУ и условия обеспечения топливом, если эти системы предусмотрены проектом.
Короткий успешный тест подтверждает работу в испытанных условиях. Продолжительность работы без основной площадки зависит также от автономности инженерных систем, обслуживания и возможностей восстановления инфраструктуры.
Что предусмотреть в проекте резервной площадки
Требования к резервному ЦОД стоит формировать из аварийного сценария: какие приложения продолжают работу, какой поток запросов они создают и сколько времени потребуется на восстановление защиты.
Если площадка уже существует, проверяют доступную мощность, распределение питания, охлаждение, сетевые подключения и размещение дополнительных узлов. Выявленные ограничения могут стать основанием для модернизации действующего ЦОД.
Если требуется новая площадка, ее инженерные параметры рассчитывают под согласованный состав оборудования и режимы работы. Для размещения на территории предприятия можно рассмотреть модульный ЦОД, предварительно оценив электроснабжение, связь и условия эксплуатации объекта.
Результатом проектирования должны стать конкретные параметры: какую нагрузку принимает площадка, какие отказы выдерживает, сколько работает автономно и как проходит восстановление копий без нарушения согласованных требований к приложениям.
СИНТО выполняет поставку и запуск модульных ЦОД. Для обсуждения резервной площадки подготовьте схему инфраструктуры, перечень критичных приложений, состав оборудования и параметры нагрузки. Эти данные нужны, чтобы определить инженерные мощности, подключения и критерии приемки будущего ЦОД.